アプリは「正解」と言った
スマホに向かって、らきょう とつぶやいた。アプリには✓が出た。
単語は 妥協 でした。私が言ったのはそれではない。人間なら絶対に頷かない発音で、そして「その違いが分かること」こそがこの機能の存在理由です。
これはふつうのバグより質が悪い。クラッシュは「何かがおかしい」と教えてくれます。偽の✓は、覚えていない単語を「覚えた」と信じ込ませる——自分が何を知っているかを正直に記録することだけが仕事のツールで。壊れるだけでなく、測っている対象を静かに汚していく。
原因は、自分で気を利かせたつもりで書いた1行でした。
r.maxAlternatives = 5;
音声認識は、順位のついた候補リストを返してきます。5にしたのは寛容さのつもりでした——次点まで拾えば、多少の訛りは許してくれるだろう、と。結果、判定が無意味になりました。妥協 が候補の4番目に座っていたので、私のつぶやきが通ってしまった。
認識が間違っていたのではなく、私の問いが間違っていました。知りたいのは「正解が認識器の頭のどこかにあったか」ではなく、「私がそう言ったか」です。候補は1つ、それを判定する。
何を作っていたか
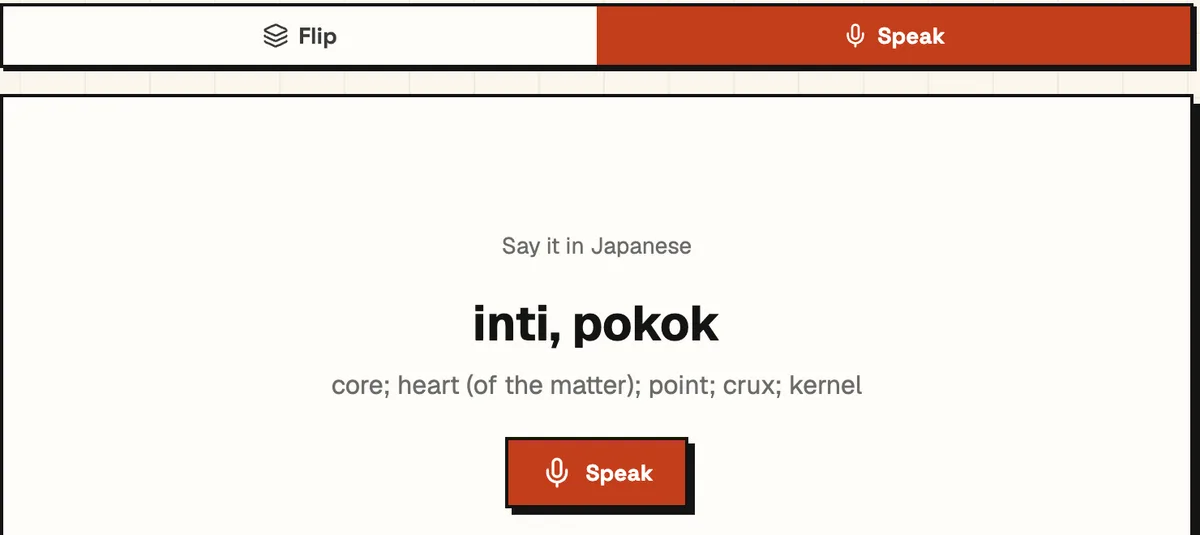
tangochoは自作の日本語単語アプリです。ここにSpeak modeを追加しました。意味が表示される → 声に出して言う → 合っているか判定される → 正しい発音が読み上げられる、という流れです。
音声APIは使っていません。Whisperもなし、Google Speech-to-Textもなし、音声のアップロードもなし、従量課金もなし、自分の声が溜まっていくストレージもなし——ブラウザのAPI2つと、70行ほどの文字列比較だけ。理由の半分は、tangochoがユーザー1人のために無料枠で動いているから。もう半分は、アクセントを採点したいわけではないからです。「妥協」という単語を、意味だけを見て、声に出して思い出せるか。想起に必要なのは○か×だけ。
ベクトルDBなしのRAGで書いたのと同じ話です——安いほうが正しいことは多い。
再生する側は4行で済みます。speechSynthesisはもう何年も全ブラウザに入っているので。
// lib/speech.ts
export function speak(text: string) {
  if (!('speechSynthesis' in window)) return;
  speechSynthesis.cancel();
  const u = new SpeechSynthesisUtterance(text);
  u.lang = 'ja-JP';
  speechSynthesis.speak(u);
}
答えを表示したときに、カードの読み(かな、なければ単語そのもの)を再生します。音声ファイルなし、ホスティングなし、保存なし。
ひとつ正確に書いておきたいことがあります。「ブラウザ内で完結」は盛って言いやすいので。私は音声を一切受け取りませんが、ブラウザはどこかに送っているかもしれません。 Chromeの認識は基本的にサーバー側で、音声はGoogleに送られます——ふつうの音声入力と同じです。iOSではシステムの音声入力の仕組みを通ります。私が正直に言えるのは、tangocho自体は何もアップロードせず、何も保存せず、何も払っていない、ということだけ。プライバシーの境界はブラウザ側にあって、私の側にはない。マイクをアプリに入れる前に知っておく価値があります。
そして、聞き取る側に3つのバグが全部住んでいました。
判定は機械学習ではなく、文字列比較
認識はテキストを返してきます。それが正解かどうかを決めるところに本当のロジックがあって、これが拍子抜けするほど素朴です。
// カタカナ→ひらがな、空白と記号を落とす。ショクジ が しょくじ に一致するように。
export function normalize(s: string) {
  return s
    .replace(/[ァ-ヶ]/g, (c) => String.fromCharCode(c.charCodeAt(0) - 0x60))
    .replace(/[\s\p{P}]/gu, '');
}

export function isMatch(raw: string, word: { term: string; reading: string | null }) {
  const heard = normalize(raw);
  return [word.term, word.reading]
    .filter(Boolean)
    .map((t) => normalize(t!))
    .some((t) => heard === t || (t.length >= 2 && heard.includes(t)));
}
ここには意味のある判断が2つ入っています。カタカナとひらがなは同じ音なので、しょくじ に対して ショクジ が返ってきたら一致であって不正解ではない。そして長い文の中に単語が入っていても正解にする——食べ物 のつもりで 食べ物です と言っても、言えている——ただし2文字以上の単語だけ。1文字のかなは、ほとんどどんな文にも偶然含まれてしまうからです。
バグ②:正しく言ったのに不正解にした
日本語は同音異義語だらけで、認識は文脈なしに音から漢字を決めないといけません。感傷 と言うと、よく 鑑賞 が返ってきます。違う単語、同じ かんしょう。完璧に言ったのに✗が出る。
直し方は、文字ではなく読みを比べること。聞き取れた語をJishoで引いて、漢字が違っても読みが一致するなら正解にする。
この照会は非同期で、そこからすぐに、もっと意地の悪いバグが出ました。カードに一瞬✗が出て、0.5秒後に✓へ直る。技術的には正確でも、気持ちとしては最悪です——もう「間違えた」と感じてしまった後なので。なので結果の状態は2つではなく3つあります。
if (isKana(heard)) return setSpoken({ text: heard, status: 'miss' });

setSpoken({ text: heard, status: 'checking' });
const reading = await lookupReading(heard);
if (heardId.current !== id) return;
if (reading && normalize(reading) === normalize(word.reading ?? word.term)) {
  // 認識がたまたま選んだ漢字ではなく、読みのほうを表示する。
  return setSpoken({ text: reading, status: 'match', note: 'same reading' });
}
確認中はスピナー。撤回するかもしれない判定は出さない。(heardIdのガードは、Jishoの返事を待たずにもう一度マイクを押せるから——古い返事には負けてもらう必要があります。)
バグ③:SafariがisFinalを返さない
認識器のセットアップは、傷跡も含めてこれで全部です。
export function createRecognition(): Recognition | null {
  const w = window as unknown as Record<string, (new () => Recognition) | undefined>;
  const Ctor = w.SpeechRecognition ?? w.webkitSpeechRecognition;
  if (!Ctor) return null;
  const r = new Ctor();
  r.lang = 'ja-JP';
  r.maxAlternatives = 1;   // ← バグ①
  r.interimResults = true; // ← バグ③
  return r;
}
SpeechRecognitionはまだベンダープレフィックスが必要なブラウザがあり、TypeScriptのDOM型定義にも入っていないので、実際に触るメンバーだけ自分で宣言しています。
最後の1行がSafari対策です。Chromeでは最終結果が飛んできて終わり。Safariでは、私が試した限り、ずっと……途中結果を返し続けて、どれも「最終」にならない。結果、最初の版はノートPCでは完璧に動いて、スマホでは何も返さなかった。実際にアプリを使う場所はスマホだけなのに。
直し方は、来ないかもしれないisFinalを待つのをやめること。最新の途中結果を持っておいて、無音がひと呼吸続いたらマイクを閉じ、終わった時点で手元にあるものを結果として報告する。
r.onresult = (e) => {
  latest = e.results[0][0]?.transcript ?? null;
  clearTimers();
  if (e.results[0].isFinal) r.stop();
  else timers.current.push(setTimeout(() => r.stop(), 1200));
};
r.onend = () => { setListening(false); if (latest) onResult(latest); };
加えて10秒の安全網。誰も閉じないマイクは、バッテリーを食うバグです。
Safariにはもう一つ罠があって、システム設定で音声入力(Dictation)を有効にしていないとservice-not-allowedを投げます。反応しないボタンから、それを推測できるユーザーはいません。なのでこのエラーは「どこを見ればいいか」のヒントに変換して、どんな場合でも「答えを見る」は動くようにしています。ハードウェアの権限に乗っている機能には、ブラウザに断られたときの筋書きが要ります。
いくらかかって、何ができないか
かかるのはゼロ円。できないことは、それなりにあります。毎日使う発音チェックが、ブラウザの中で、限界費用ゼロ、3ファイル170行ほど——ただし限界つきで。
- アクセントの評価はできない。 「何と聞こえたか」は分かっても「どれくらい上手か」は分からない。日本語話者なら気づく平板なイントネーションも素通りします。
- ブラウザ対応がまばら。 ChromeとiOSは問題なし。Firefoxには実装がなく、Safariは先にシステム設定が要ります。
- 認識器が天井を決める。 完璧に言ったのに聞き取られなければ、こちらが偽陰性をかぶる。同音異義語に読み照会が必要だった理由もそこで、スコアより「もう一度」ボタンのほうが大事な理由もそこです。
本物の発音評価——ピッチアクセント、モーラ単位のフィードバック、学習者が実際に頭打ちになるところ——が欲しくなった日に、これは全部捨てます。そのときは有料の音声モデルに課金し、音声をアップロードし、それに見合うプライバシーの説明を書くことになる。
振り返ると、3つのバグは同じ間違いが服を着替えただけでした。認識の出力を「判決」として扱っていたけれど、あれは「証拠」でしかない。候補5つは答え5つではない。認識が選んだ漢字は、私が言った単語ではない。まだ最終と印がついていない結果も、結果ではある。認識器に「正しくあれ」と求めるのをやめて、「何が聞こえたか」だけを尋ねるようにしたら、あとは文字列比較で済みました。